



Mở đầu: Agent không chỉ “suy nghĩ”, nó liên tục “ra quyết định”
Một AI agent dành rất ít thời gian cho việc mà ta hay gọi là “suy luận”. Phần lớn một lần chạy là hàng loạt quyết định nhỏ xen giữa các bước làm việc chính.
Ví dụ, trong lúc sửa một bug, agent (hay đúng hơn là harness bao quanh nó) phải liên tục trả lời:
- Bước tiếp theo nên giao cho model nào?
- Lệnh shell sắp chạy có nguy hiểm không?
- Task đã xong chưa, hay còn phải làm tiếp?
- Agent có đang bị kẹt trong vòng lặp không?
- Kết quả này đã đủ tốt để đi tiếp chưa?
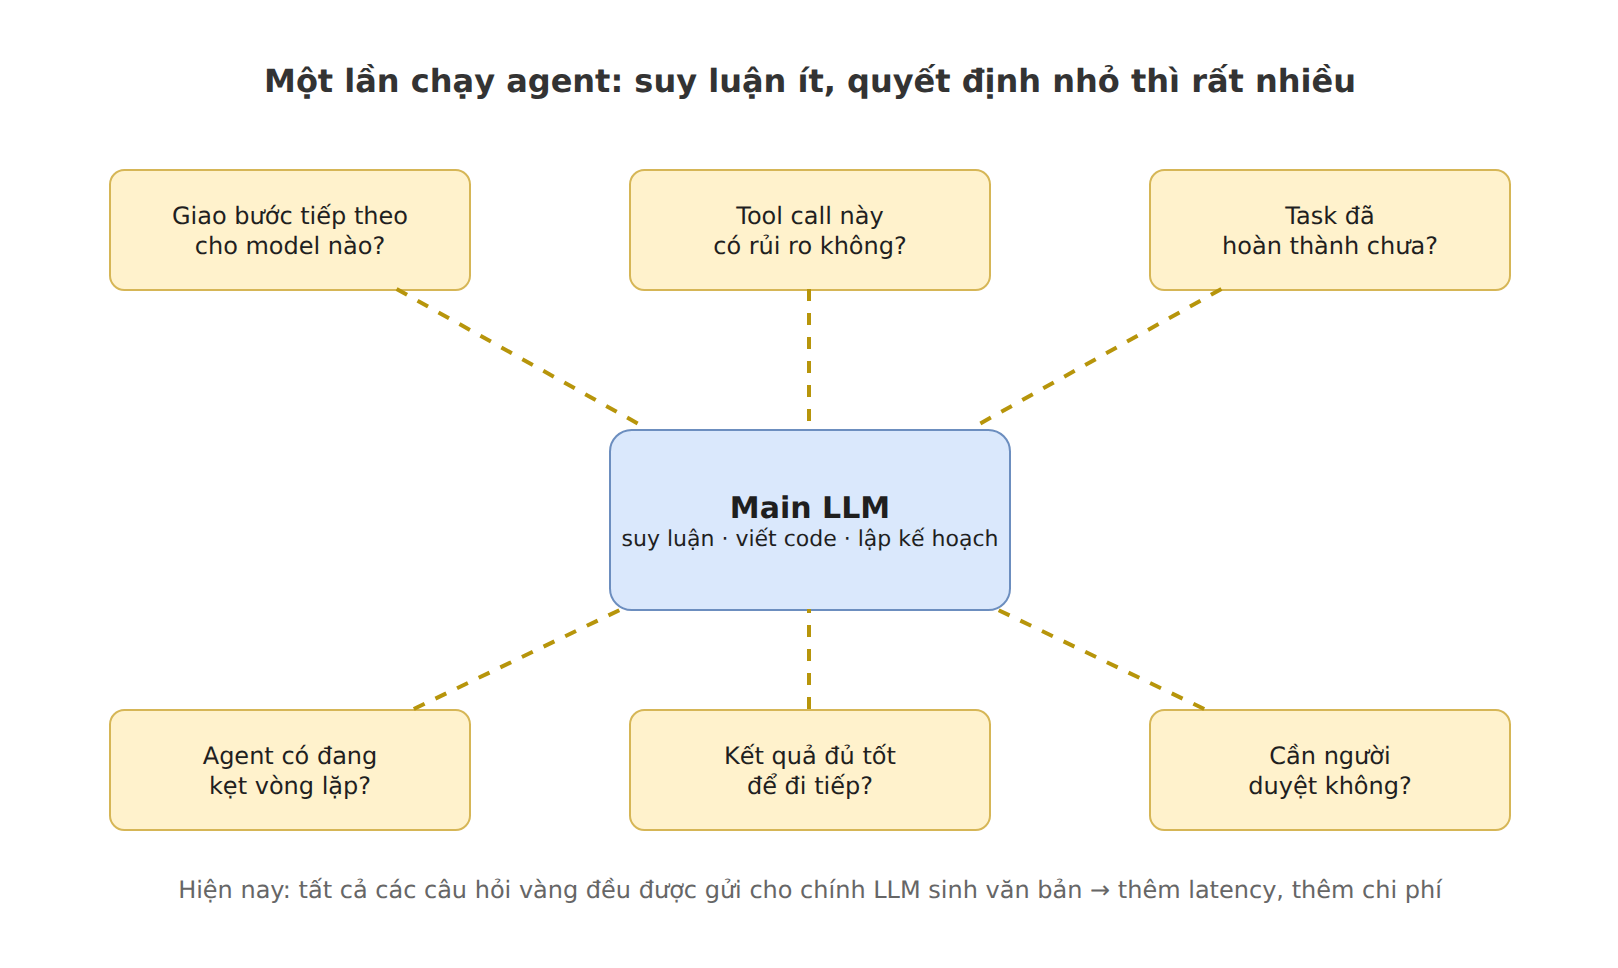
Hiện nay, hầu hết hệ thống dùng cùng một LLM sinh văn bản cho tất cả các câu hỏi đó. Tức là gọi một model được thiết kế để viết đoạn văn, viết code, suy luận dài… chỉ để trả lời “Có” hoặc “Không”.
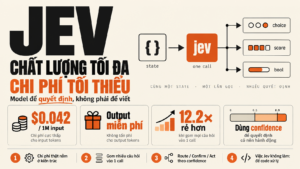
JEV (của TypeSafe AI) đi theo hướng khác: một model chuyên cho quyết định nhanh và có cấu trúc. Bạn đưa vào trạng thái (state), định nghĩa câu hỏi, và nhận về câu trả lời có kiểu (typed) kèm xác suất — ứng dụng dùng được ngay, không cần parse văn bản. TypeSafe gọi lớp model này là “System One models” — như “hệ thống 1” trong não người: phản xạ nhanh, trực giác, thay vì suy nghĩ chậm và dài.
JEV là gì? Không phải “một LLM nhỏ hơn”
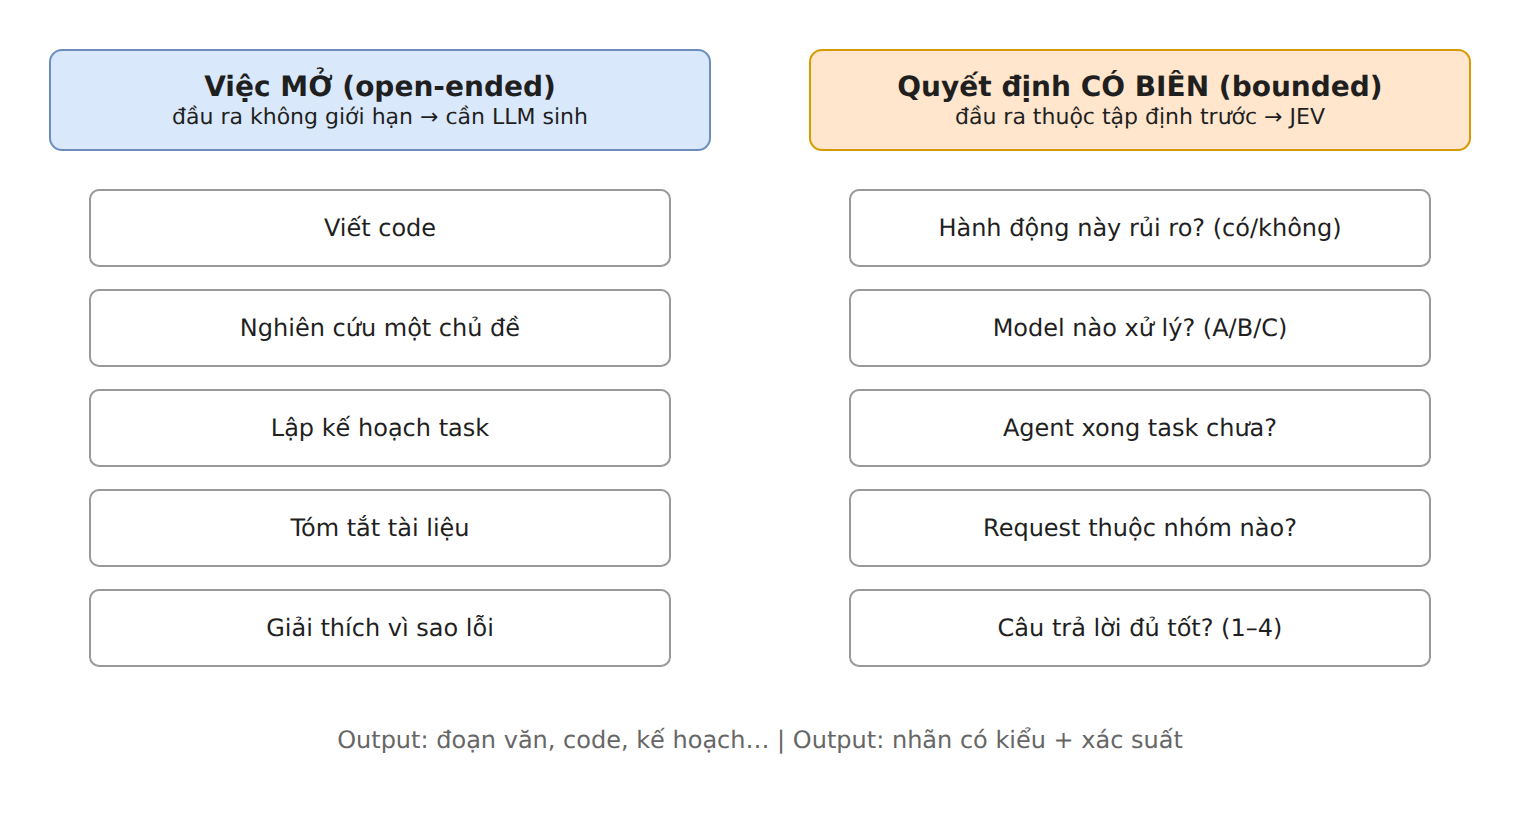
Cách dễ nhất để hiểu JEV là tách công việc của AI thành hai loại:
| Việc mở (open-ended) | Quyết định có biên (bounded) | |
|---|---|---|
| Ví dụ | Viết code, nghiên cứu, lập kế hoạch, tóm tắt, giải thích | Hành động có rủi ro? Model nào xử lý? Đã xong chưa? Thuộc nhóm nào? Đủ tốt chưa? |
| Đầu ra | Văn bản, code, kế hoạch — không giới hạn | Một giá trị trong tập định sẵn + xác suất |
| Công cụ phù hợp | LLM sinh văn bản | JEV |
Với JEV, bạn không yêu cầu nó viết đoạn văn tiếp theo. Bạn yêu cầu nó chọn một đáp án trong không gian đầu ra đã định nghĩa trước.
Ví dụ: một support ticket có nội dung “Deploy lỗi hai lần và khách hàng đang thấy lỗi 500”, với câu hỏi “Có cần xử lý ngay không?”. Thay vì sinh ra câu “Có, việc này có vẻ khẩn cấp vì khách hàng đang…”, JEV trả về thẳng urgent = true kèm xác suất. Xác suất đó là thứ ứng dụng dùng để hành động.
Gọi JEV là “classifier” cũng không sai, nhưng chưa đủ. Ý tưởng rộng hơn là: một model cho các quyết định ngữ nghĩa có biên, mà phần mềm tiêu thụ trực tiếp được.
Khác gì với việc bắt LLM trả về JSON?
Câu hỏi hay gặp: “LLM bây giờ đã hỗ trợ structured output rồi mà?” Đúng vậy — bạn có thể bắt LLM trả về:
Nhưng bên dưới, model vẫn sinh token từng cái một (autoregressive) rồi bị ép cho khớp với schema. JEV thay đổi nơi cấu trúc được sinh ra: cấu trúc nằm sẵn trong câu hỏi, model chỉ việc chấm điểm các đáp án.
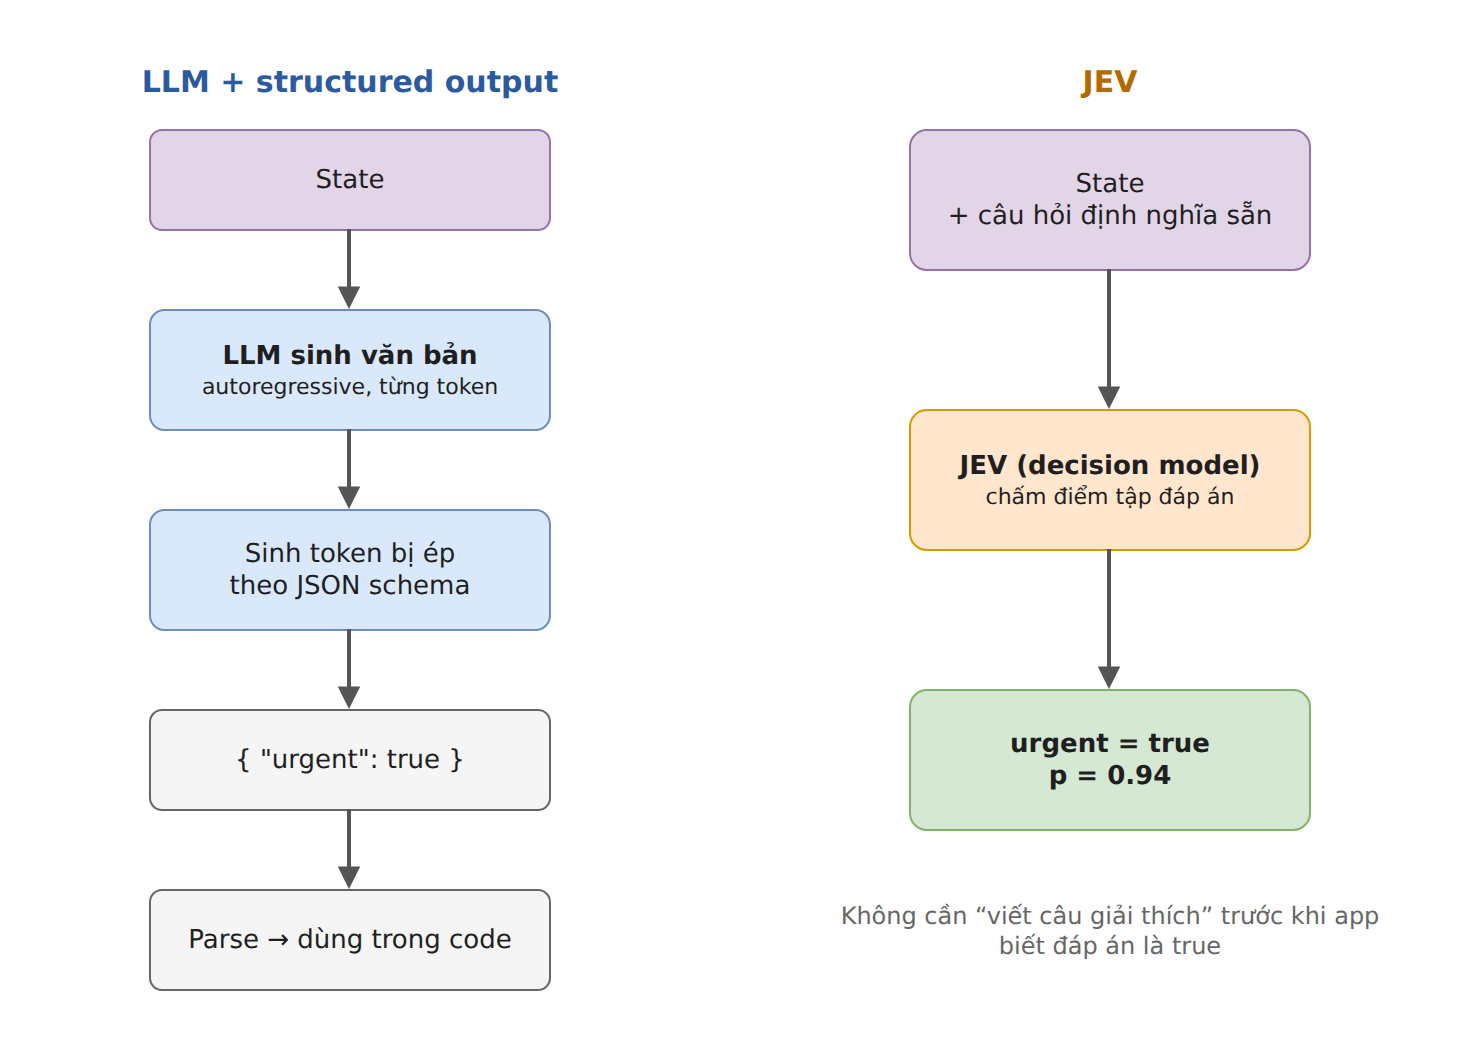
| LLM + structured output | JEV | |
|---|---|---|
| Cách làm | Sinh token, ép theo schema | Đánh giá trực tiếp tập đáp án định sẵn |
| Đầu ra | Chuỗi JSON, cần parse | Giá trị có kiểu + xác suất |
| Độ tin cậy | Thường phải tự đọc log-prob hoặc bắt model tự cho điểm | Xác suất là output chính thức, được hiệu chuẩn (calibrated) |
| Chi phí / độ trễ | Như một lượt gọi LLM đầy đủ | Thấp hơn nhiều (theo TypeSafe) |
Nói gọn: JEV không cần viết câu giải thích rằng việc này khẩn cấp trước khi ứng dụng biết đáp án là true.
Một request JEV gồm những gì?
Mỗi request có hai phần: State (thông tin mà quyết định dựa vào) và một hoặc nhiều câu hỏi về state đó. State có thể là support ticket, trajectory của agent, một tool call được đề xuất, hay trạng thái ứng dụng.
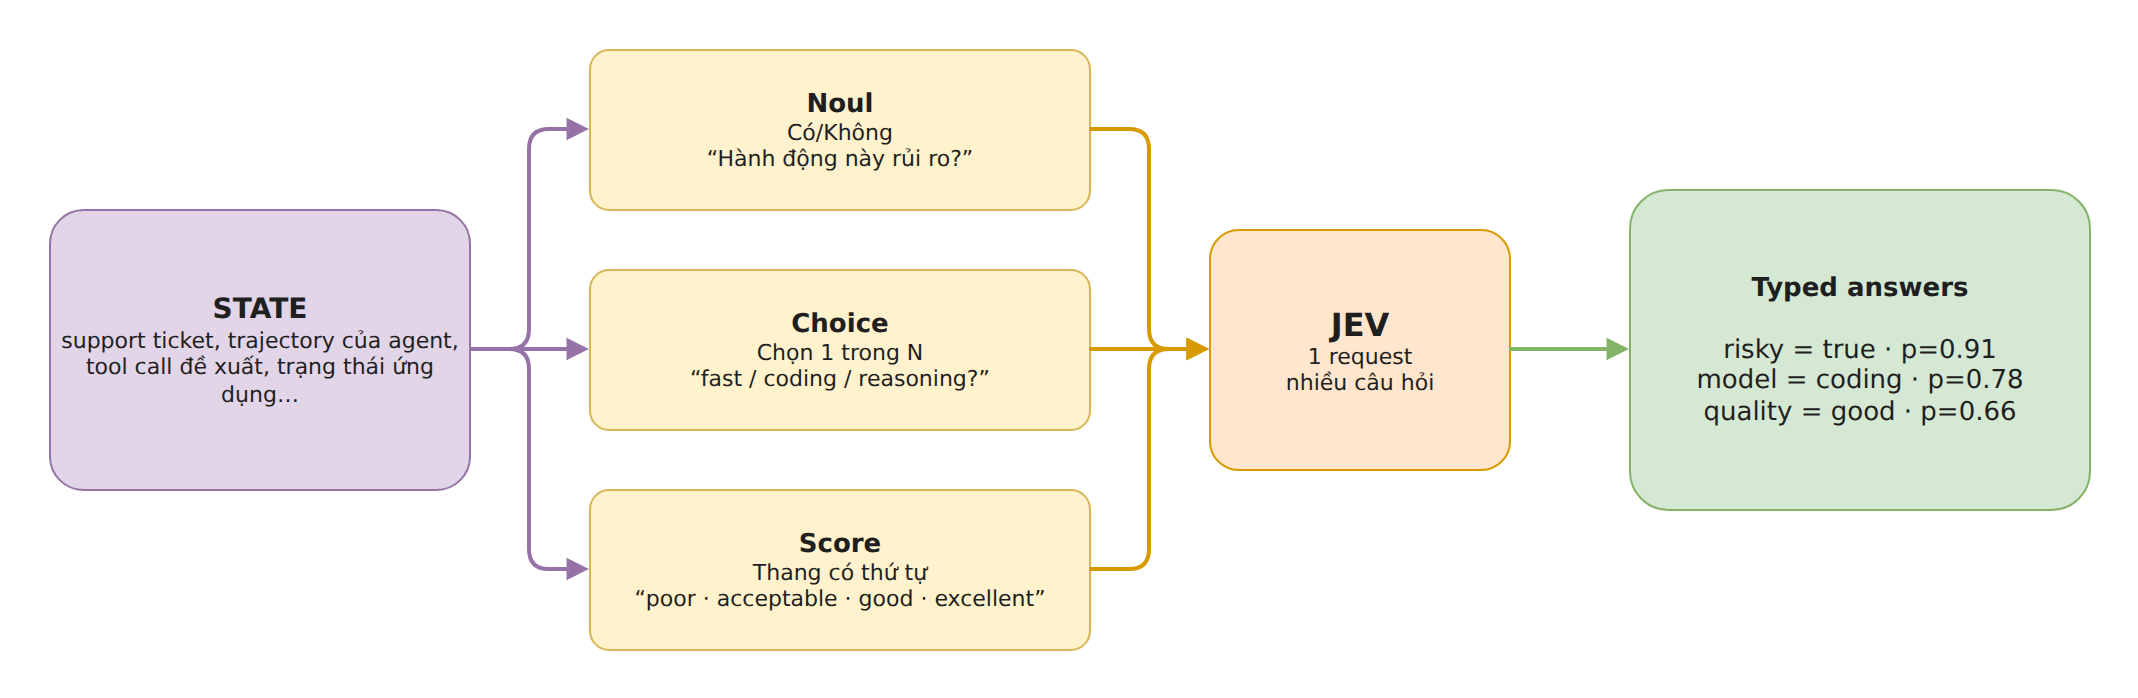
JEV hiện hỗ trợ ba kiểu câu hỏi:
| Kiểu | Ý nghĩa | Ví dụ câu hỏi | Đầu ra |
|---|---|---|---|
| Noul | Có / Không | “Agent muốn xóa một thư mục — hành động này có rủi ro?” | true / false + xác suất |
| Choice | Chọn 1 trong N lựa chọn | “Task này nên giao cho fast / coding / reasoning model?” | Một lựa chọn + xác suất từng lựa chọn |
| Score | Mức trên thang có thứ tự | “Agent hoàn thành task tốt đến đâu? poor / acceptable / good / excellent” | Một mức + phân phối xác suất |
Với Noul, ứng dụng dùng xác suất để rẽ nhánh: rủi ro thấp → chạy; chưa chắc → kiểm tra thêm; rủi ro cao → cần duyệt. Với Choice, JEV đánh giá các lựa chọn định sẵn thay vì tự sinh tên model từ văn bản tự do — nên rất hợp cho model routing. Score hữu ích cho eval, kiểm tra chất lượng câu trả lời, hay quyết định agent có nên làm tiếp.
Điểm đáng giá: nhiều câu hỏi có thể đi chung một request trên cùng state. Thay vì 4 lượt gọi model riêng cho “rủi ro?”, “xong chưa?”, “cần người duyệt?”, “bước sau dùng model nào?”, bạn gửi một lần.
Mô phỏng một request (minh họa ý tưởng, tên trường có thể khác schema chính thức tại docs.typesafe.ai):
{
“state”: “Agent đề xuất chạy: rm -rf ./build (repo frontend, sau khi test pass)”,
“questions”: [
{ “id”: “risky”, “type”: “noul”, “text”: “Hành động này có cần người duyệt?” },
{ “id”: “model”, “type”: “choice”, “text”: “Bước tiếp theo giao cho model nào?”,
“options”: [“fast”, “coding”, “reasoning”] },
{ “id”: “quality”, “type”: “score”, “text”: “Tiến độ task hiện tại?”,
“levels”: [“poor”, “acceptable”, “good”, “excellent”] }
]
}
Kiến trúc agent 3 tầng: LLM làm, JEV quyết, Runtime thực thi
Hãy hình dung user yêu cầu: “Tìm bug trong repo này và sửa nó”. LLM chính đọc file, tìm kiếm, đề xuất hành động. Nhưng xung quanh nó, harness cần trả lời liên tục: model nào làm bước này, tool nào liên quan, lệnh shell có nguy hiểm, tool call trước có thành công, agent còn tiến triển không, task đã xong thật chưa.
Không câu nào trong số đó cần một model khác viết hàng trăm token. Đó chính là tầng mà JEV nhắm tới:
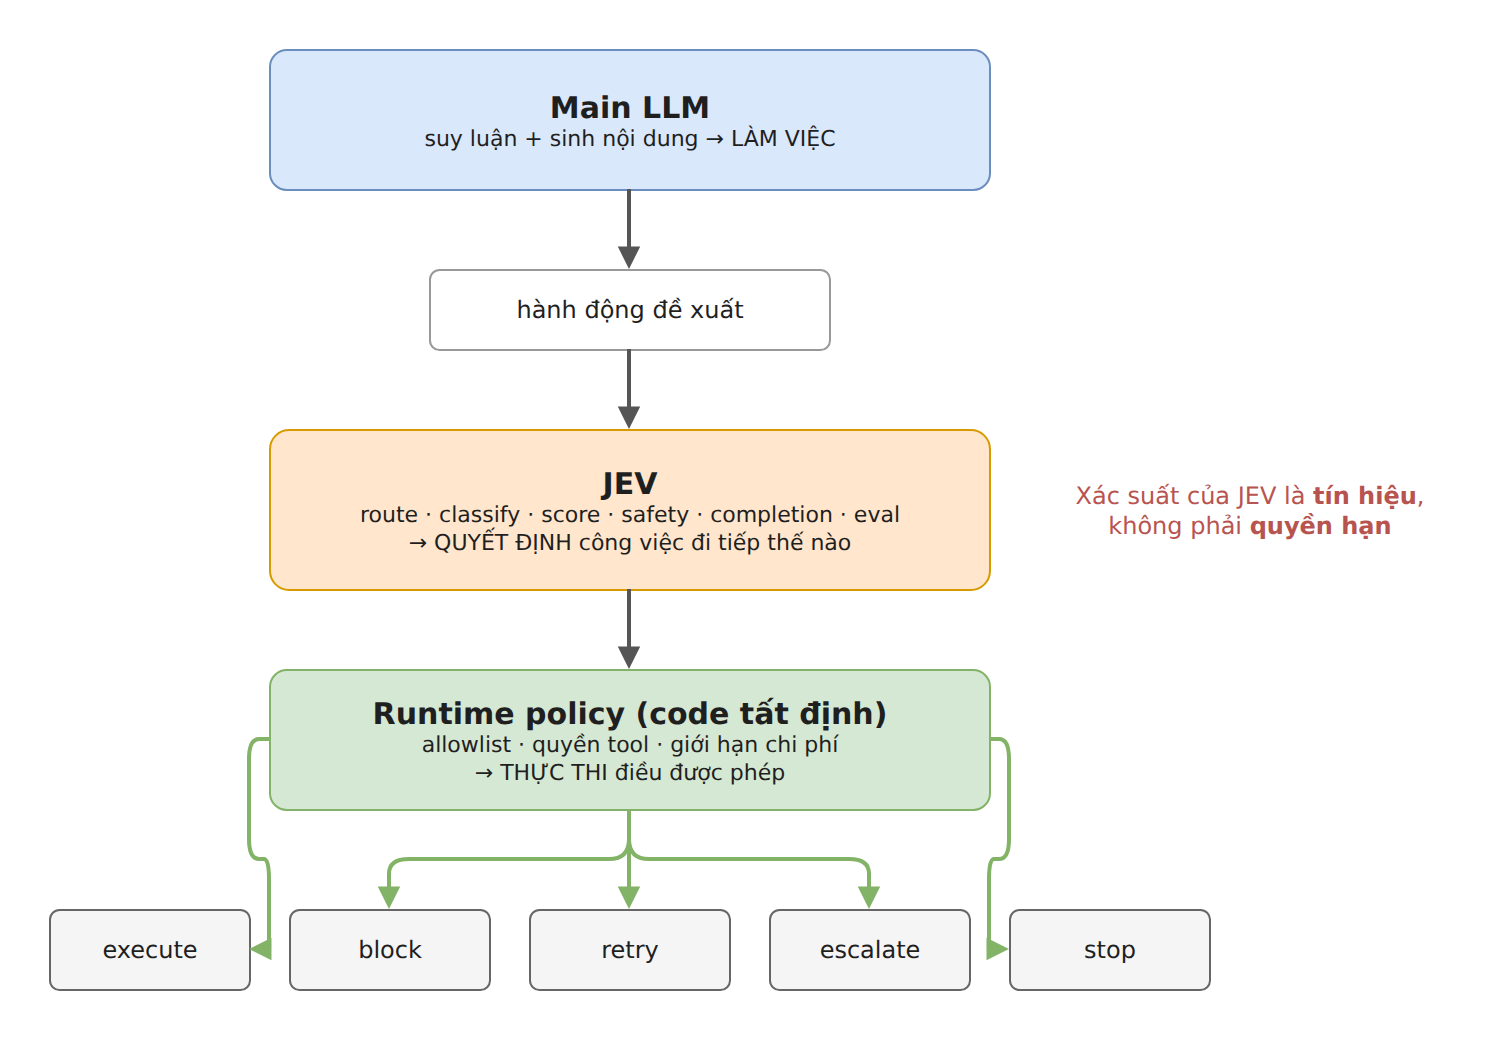
| Tầng | Vai trò | Ví dụ |
|---|---|---|
| Main LLM | Làm việc mở: suy luận, sinh nội dung | Viết bản sửa bug, giải thích nguyên nhân |
| JEV | Quyết định ngữ nghĩa có biên | Route, phân loại, chấm điểm, an toàn, hoàn thành, eval |
| Runtime (code tất định) | Thực thi điều được phép | Allowlist, quyền tool, quyền file, giới hạn chi phí → execute / block / retry / escalate / stop |
Tầng thứ ba rất quan trọng. Nếu JEV nói một lệnh có 97% khả năng an toàn, điều đó không có nghĩa JEV trở thành hệ thống phân quyền. Các ràng buộc cứng vẫn thuộc về code. JEV cung cấp phán đoán ngữ nghĩa; phần mềm quyết định phán đoán đó được phép kích hoạt điều gì.
4 vị trí JEV phát huy trong vòng lặp agent
Khi nhìn agent theo cách này, cùng một “viên gạch” quyết định xuất hiện ở bốn chỗ: Routing → Safety → Control → Evaluation.
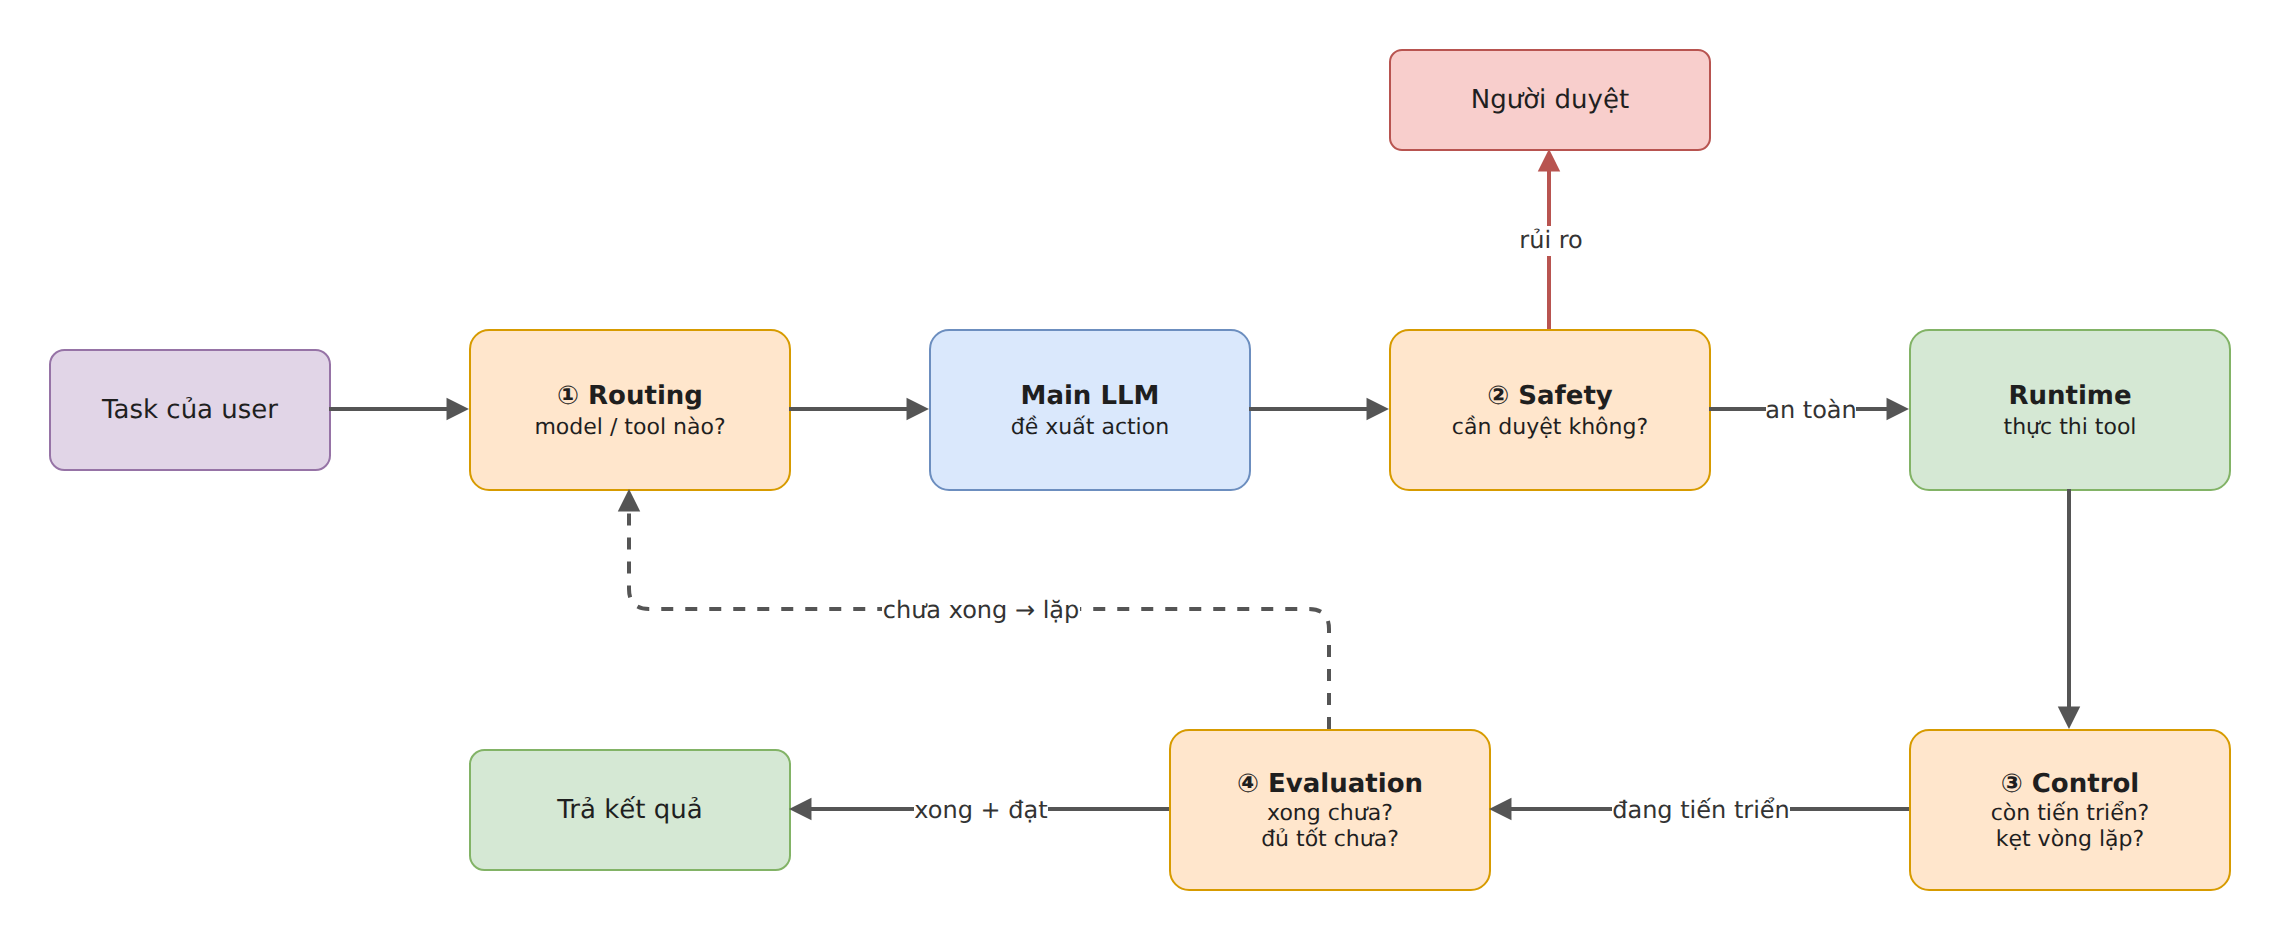
① Routing — chọn model, chọn tool
Bạn có model rẻ cho việc đơn giản và model reasoning mạnh cho việc khó. Thay vì hỏi chính model đắt “nên dùng model nào?”, JEV quyết định trước. Tương tự với tool: agent có hàng chục tool, JEV lọc ra nhóm liên quan trước khi LLM chính nhìn thấy.
② Safety — gác cổng trước khi thực thi
Lệnh rm -rf ./build có thể hoàn toàn bình thường trong ngữ cảnh này nhưng nguy hiểm trong ngữ cảnh khác. Trước khi chạy, JEV đọc hành động + state xung quanh và trả lời “Có cần duyệt không?”. JEV không chạy lệnh và không phải ranh giới bảo mật cuối cùng — nó chỉ là một tín hiệu thêm cho runtime.
③ Control — agent còn tiến triển không?
Agent chạy lâu có thể lặp search → open result → search → open result… mãi. Harness hỏi JEV: “Agent còn tiến triển có ý nghĩa?” hoặc “Có đang kẹt vòng lặp?” để dừng đúng lúc.
④ Evaluation — xong chưa, đạt chưa?
Các câu hỏi eval đều là quyết định trên tiêu chí biết trước: agent có theo đúng chỉ dẫn? task có hoàn thành đúng? câu trả lời có bám vào context? có cần người review? Không cần một model sinh cả đoạn văn giải thích cho từng phán xét.
Tốc độ, chi phí và xác suất
Vì sao tốc độ và chi phí quan trọng? Nếu chỉ gọi JEV một lần trong cả lần chạy, khác biệt không đáng kể. Nhưng các quyết định này lặp lại: route nhiều lần, kiểm tra từng tool call, check tiến độ, chấm kết quả trung gian, xác nhận hoàn thành. Một agent chạy dài có thể cần hàng chục đến hàng trăm quyết định như vậy — latency và chi phí cộng dồn. TypeSafe định vị JEV có độ trễ và chi phí thấp hơn nhiều so với dùng LLM sinh cho các quyết định kiểu phân loại.
Xác suất là một phần của output, không phải phụ kiện. Khi JEV đánh giá một hành động có rủi ro hay không, bạn có thể viết luật như sau:
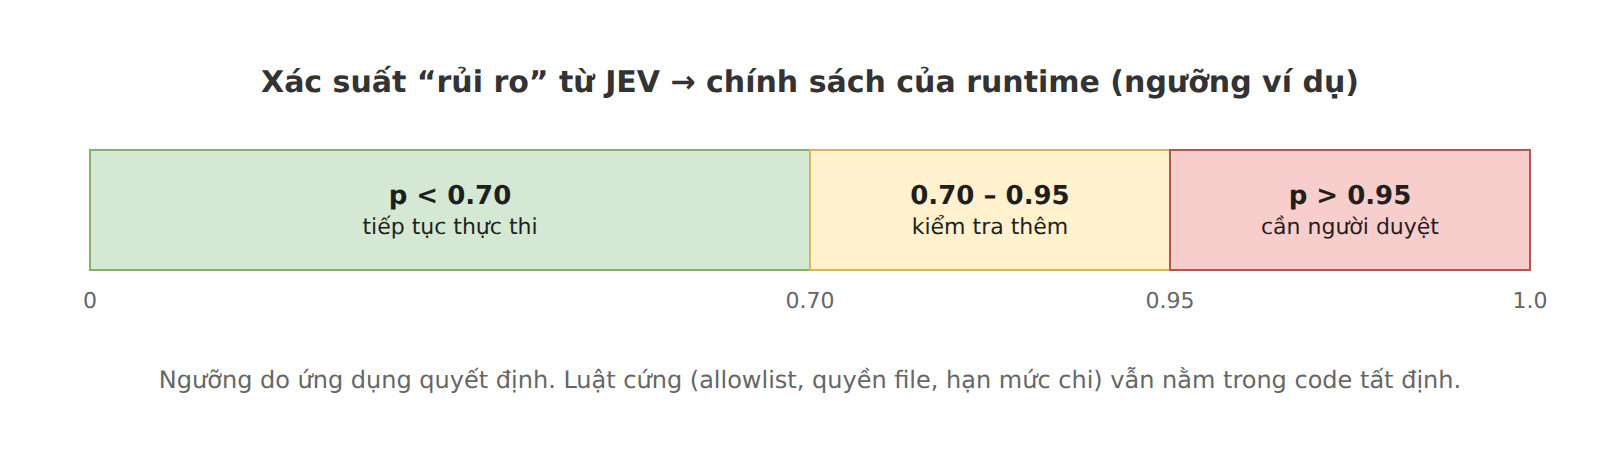
p = jev_result[“risky”].probability
if p < 0.70:
execute(action) # rủi ro thấp → chạy
elif p <= 0.95:
run_additional_check(action) # chưa chắc → kiểm tra thêm / sandbox
else:
require_human_approval(action) # rủi ro cao → người duyệt
Ngưỡng cụ thể tùy ứng dụng. Điểm mấu chốt là calibration (hiệu chuẩn): nếu model nhiều lần nói 90%, thì khoảng 90% số lần đó phải đúng — con số phải có ý nghĩa thống kê, không phải “độ tự tin” tùy ý. TypeSafe cho biết JEV được huấn luyện xoay quanh quyết định có hiệu chuẩn.
Dù vậy, model không bao giờ tuyệt đối. 99% không phải là giấy phép — nó là một tín hiệu để kết hợp với luật tất định, kiểm tra bổ sung và phê duyệt của con người khi cần.
Use cases tích hợp JEV
Sáu kịch bản dưới đây đều theo cùng một công thức: state → JEV trả lời vài câu hỏi có biên → code rẽ nhánh theo xác suất. LLM chỉ được gọi khi thật sự cần viết nội dung.
| # | Use case | State đầu vào | Câu hỏi JEV | Lợi ích chính |
|---|---|---|---|---|
| 1 | Phân loại support ticket | Nội dung ticket | Noul khẩn cấp, Choice nhóm/team, Score P1–P4 | Phản ứng sự cố nhanh hơn |
| 2 | Gác cổng cho coding agent | Tool call + ngữ cảnh | Noul cần duyệt? | Ít hỏi người vô ích, chặn đúng lúc |
| 3 | Triage bug / Q&A trên Backlog | Issue + ngữ cảnh từ RAG | Choice category/component, Score priority, Noul escalate | Giảm thời gian BrSE đọc và phân loại |
| 4 | Kiểm soát chất lượng RAG / chatbot | Câu hỏi + context + câu trả lời | Choice nguồn, Noul grounded, Score hữu ích | Giảm trả lời bịa |
| 5 | Model router tiết kiệm chi phí | Request | Choice model | Dùng model đắt chỉ khi cần |
| 6 | CI/CD & vận hành | PR diff, log deploy, alert | Noul rủi ro cao, Choice nguyên nhân, Noul rollback | Đúng người, đúng lúc |
1. Phân loại support ticket
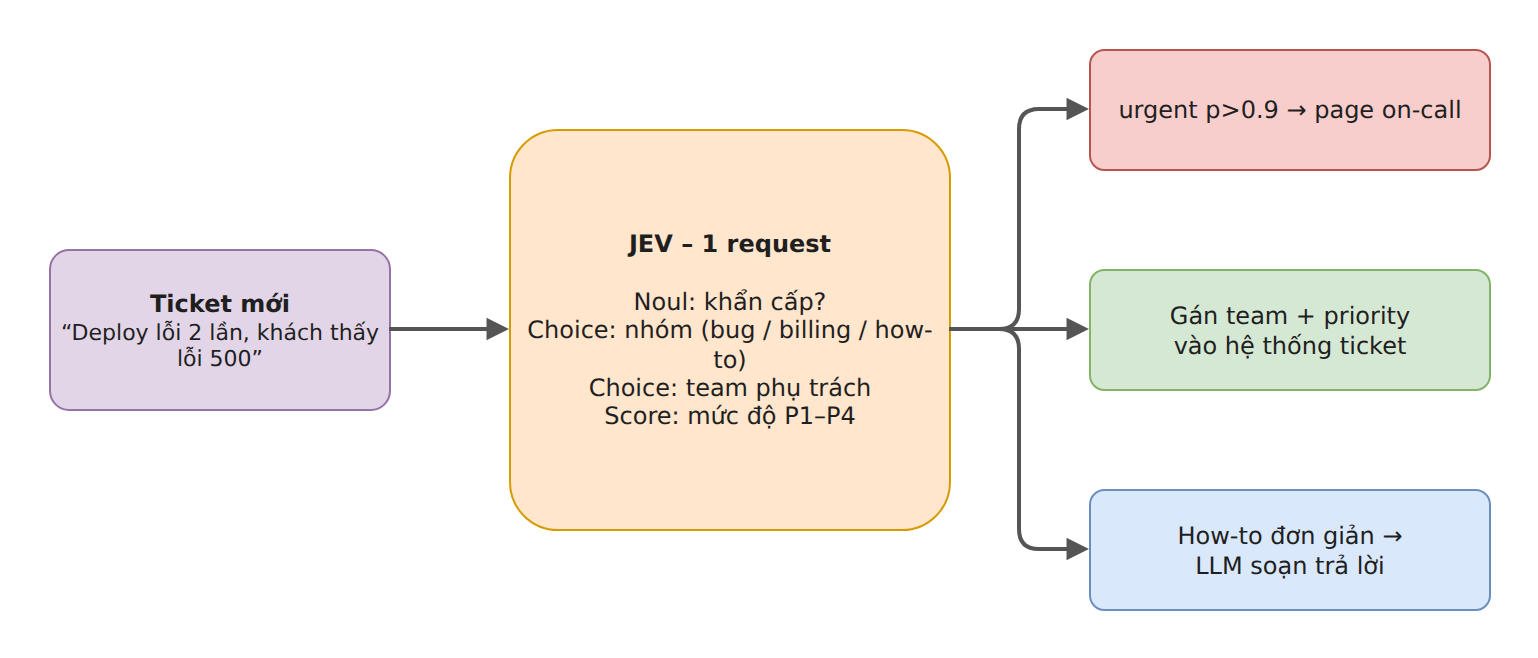
Ticket “Deploy lỗi 2 lần, khách thấy lỗi 500” đi vào. Một request JEV trả lời cùng lúc 4 câu hỏi. Nếu urgent có xác suất trên 0.9 → page người on-call ngay. Các ticket khác được gán team và priority tự động; ticket “how-to” đơn giản mới cần LLM soạn trả lời.
2. Gác cổng an toàn cho coding agent
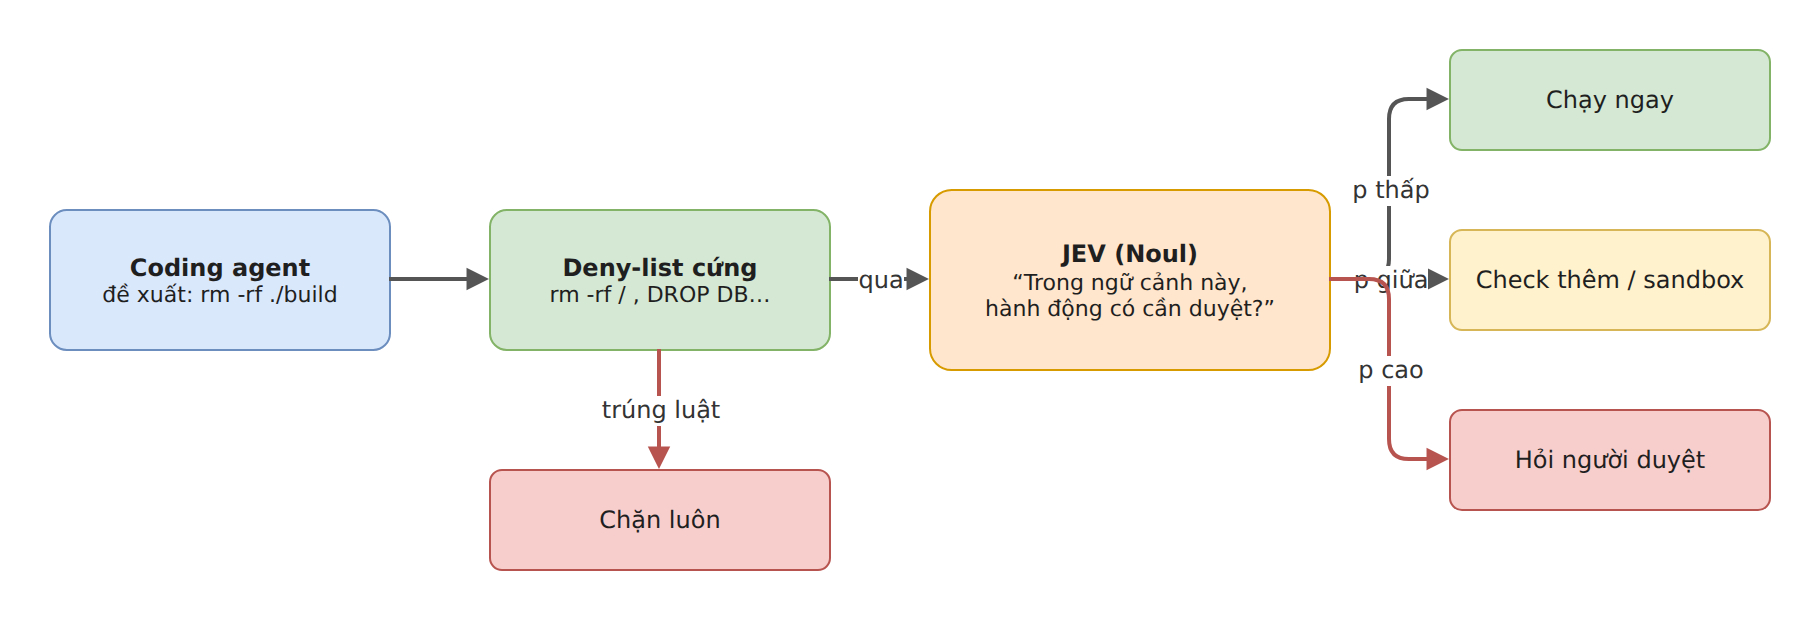
Deny-list cứng chạy trước và chặn ngay các lệnh cấm tuyệt đối. Lệnh nào qua được thì JEV xét trong ngữ cảnh: xóa ./build sau khi test pass là bình thường; xóa thư mục migration trên máy production thì không. Kết quả: người dùng chỉ bị hỏi duyệt khi thật sự cần.
3. Triage bug / Q&A từ khách hàng Nhật trên Backlog
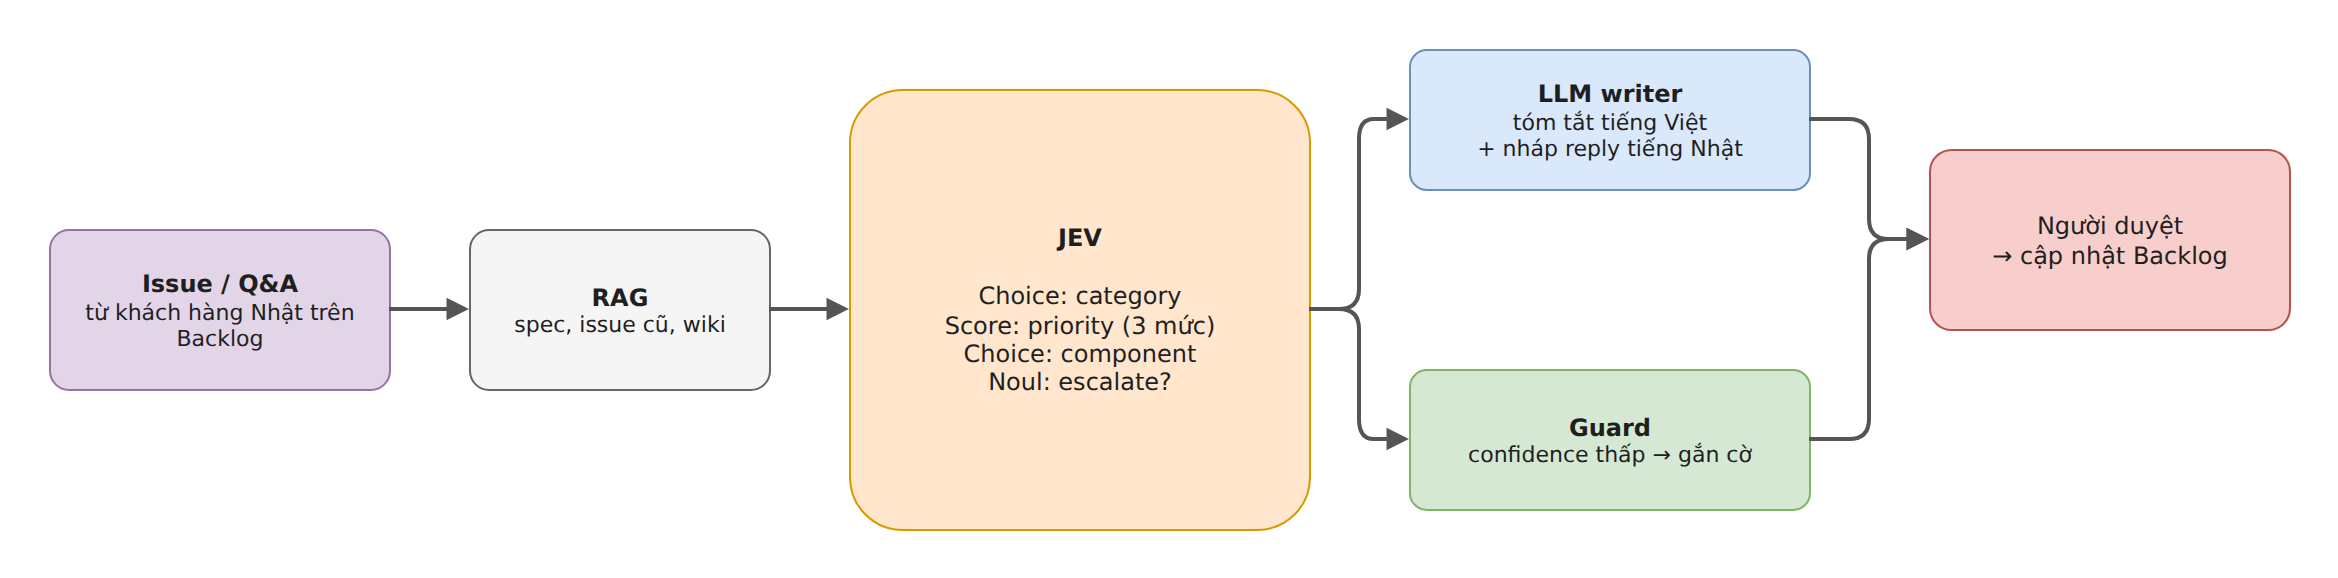
Đây là use case đầu tiên của dự án JEV Triage. Issue từ khách hàng được bổ sung ngữ cảnh bằng RAG (spec, issue cũ, wiki). JEV quyết định category (Choice), priority 3 mức (Score), component (Choice) và escalate (Noul). LLM writer chỉ làm phần viết: tóm tắt tiếng Việt và nháp reply tiếng Nhật. Guard gắn cờ khi confidence thấp; mọi thay đổi lên Backlog và reply cho khách đều qua người duyệt.
4. Kiểm soát chất lượng RAG / chatbot
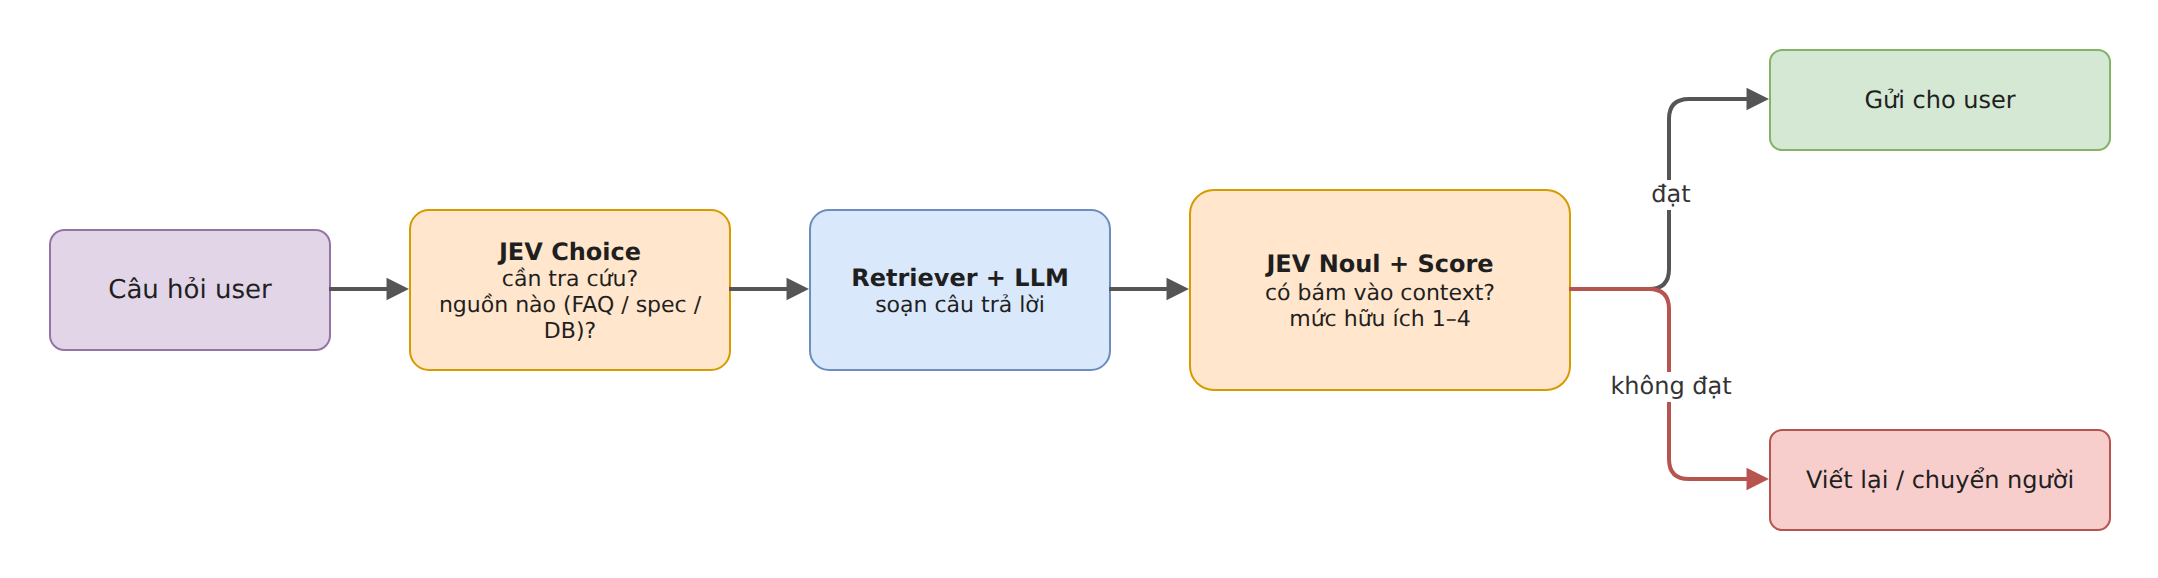
Trước khi tra cứu, JEV (Choice) quyết định có cần tra và tra ở nguồn nào. Sau khi LLM soạn xong, JEV (Noul + Score) hỏi: câu trả lời có bám vào context không, hữu ích ở mức nào. Đạt thì gửi; không đạt thì viết lại hoặc chuyển cho người.
5. Model router tiết kiệm chi phí
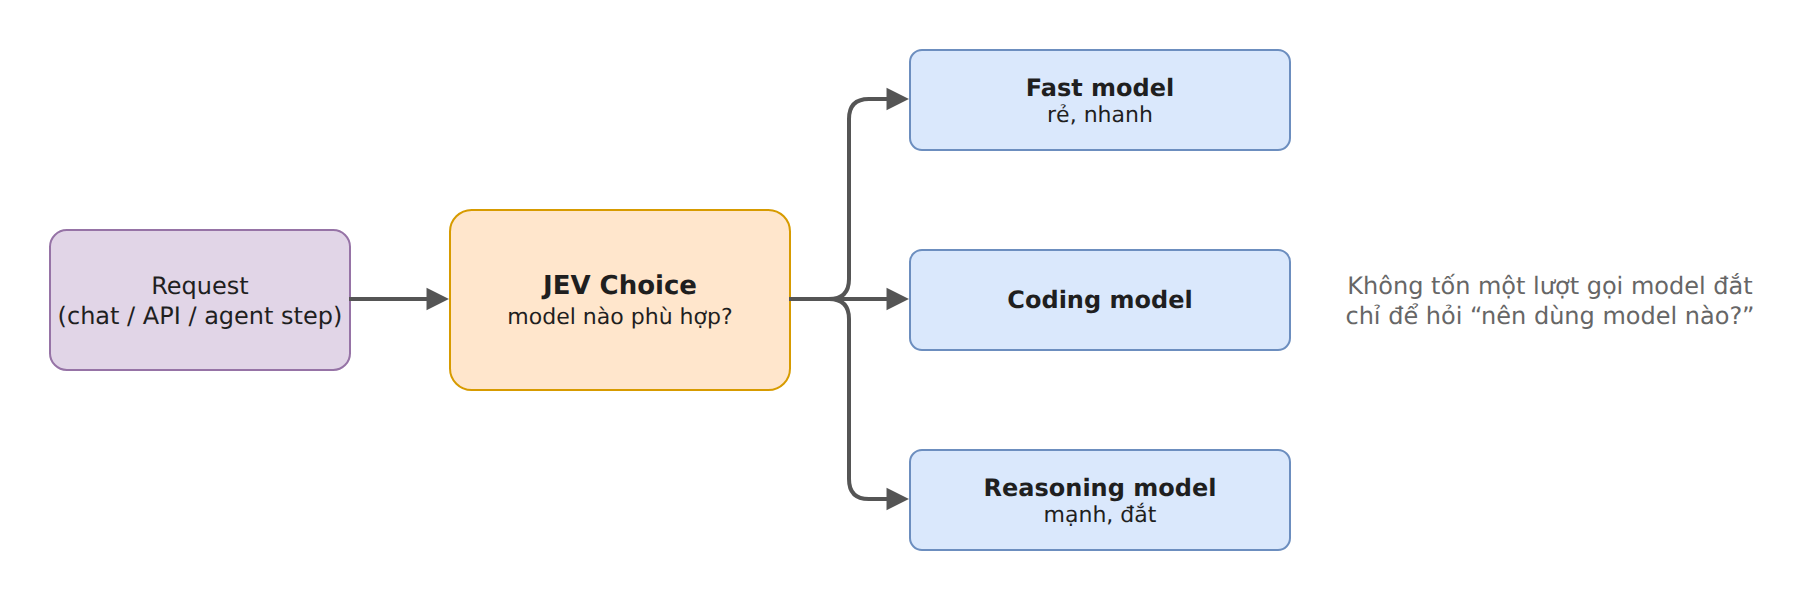
Mọi request (chat, API, hay từng bước của agent) đều đi qua JEV Choice để chọn fast / coding / reasoning model. Bạn không tốn một lượt gọi model đắt chỉ để hỏi “nên dùng model nào?”.
6. CI/CD và vận hành hạ tầng
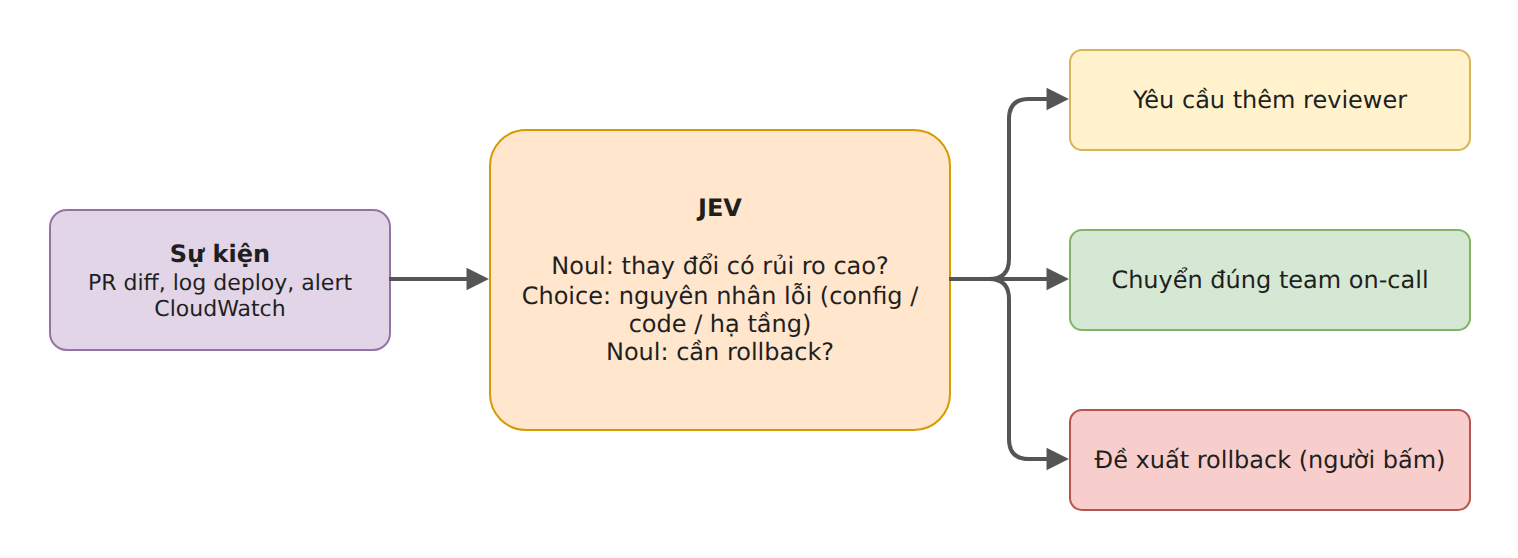
Với PR diff, log deploy hay alert (ví dụ CloudWatch), JEV trả lời: thay đổi có rủi ro cao không (→ thêm reviewer), nguyên nhân lỗi thuộc config / code / hạ tầng (→ chuyển đúng team on-call), có nên rollback không (→ đề xuất, người bấm).
Mẹo triển khai: bắt đầu ở shadow mode (JEV chạy song song, chưa được ra quyết định thật), so kết quả với người làm trong 1–2 tuần, rồi mới chọn ngưỡng xác suất cho từng hành động.
Khi nào KHÔNG nên dùng JEV
JEV không thay thế model chính. Nếu task là viết hàm này, nghiên cứu chủ đề này, debug đoạn code này, tóm tắt báo cáo, lập kế hoạch, giải thích vì sao hệ thống lỗi — bạn vẫn cần LLM sinh, vì đầu ra là không giới hạn.
Một câu hỏi đơn giản để chọn đúng công cụ:
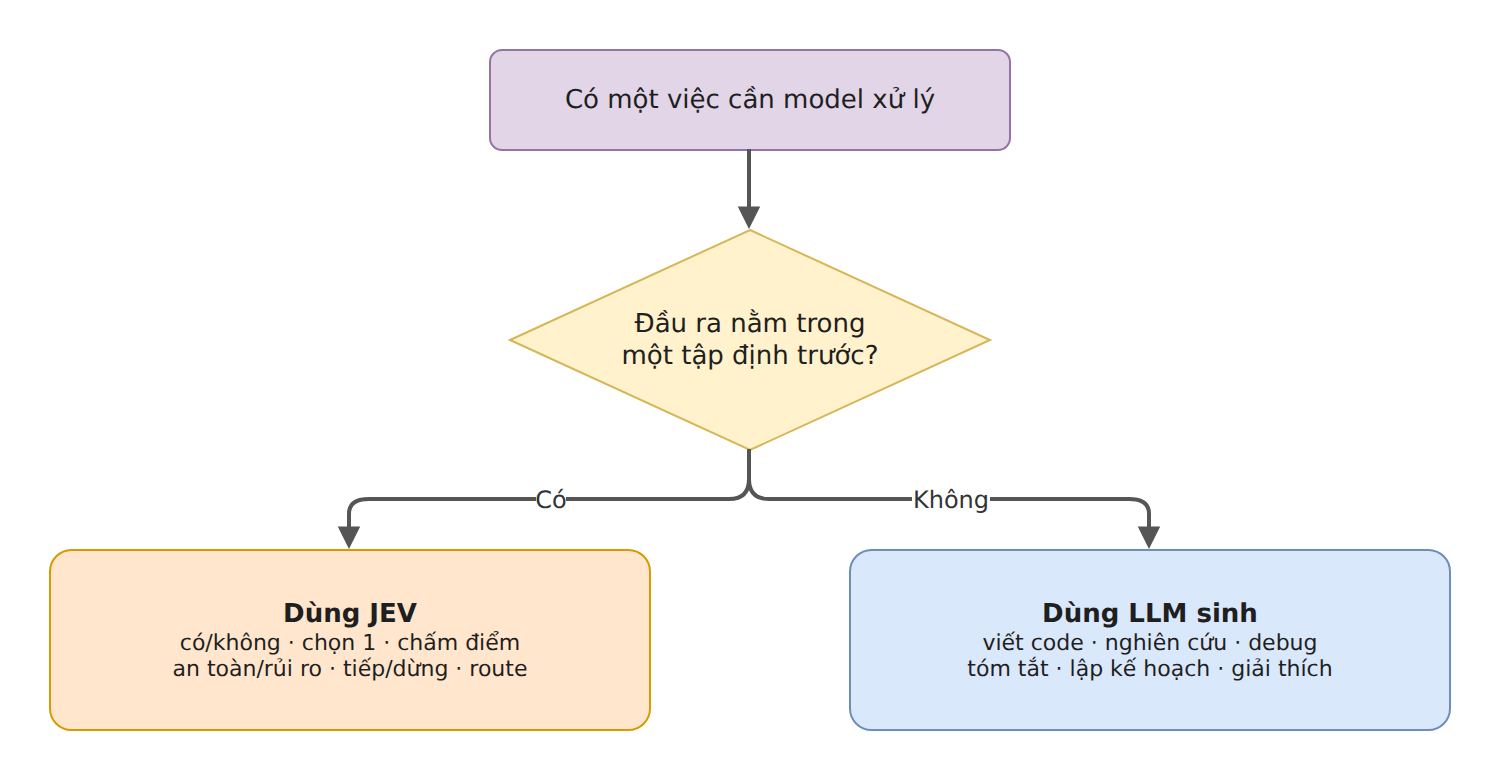
JEV phù hợp khi câu trả lời có dạng: có hay không · cái nào · tốt đến đâu · an toàn hay rủi ro · tiếp hay dừng · route đi đâu. Ngoài ra, JEV cũng không nên là lớp bảo mật duy nhất — quyền hạn cứng luôn nằm trong code.
Tổng kết: Tách “người làm” khỏi “người quyết”
Điều thú vị nhất về JEV không phải là nó nhỏ hơn, mà là cách chia kiến trúc nó gợi ý:
| Thành phần | Nhiệm vụ |
|---|---|
| LLM | Làm việc: suy luận, code, nghiên cứu, sáng tạo |
| Decision model (JEV) | Quyết định công việc đi tiếp thế nào: route, gác cổng, chấm điểm, eval, điều khiển |
| Runtime | Thực thi điều thực sự được phép |
Thay vì “một model làm tất cả”, agent trở thành một hệ thống có phân vai rõ ràng: rẻ hơn, nhanh hơn, và dễ kiểm soát hơn nhờ xác suất có hiệu chuẩn. Khi agent chạy ngày càng lâu và tự chủ hơn, những quyết định nhỏ quanh model chính có thể quan trọng không kém chính model đang suy luận.
Tham khảo: TypeSafe API docs.
Vui lòng đăng nhập để bình luận.